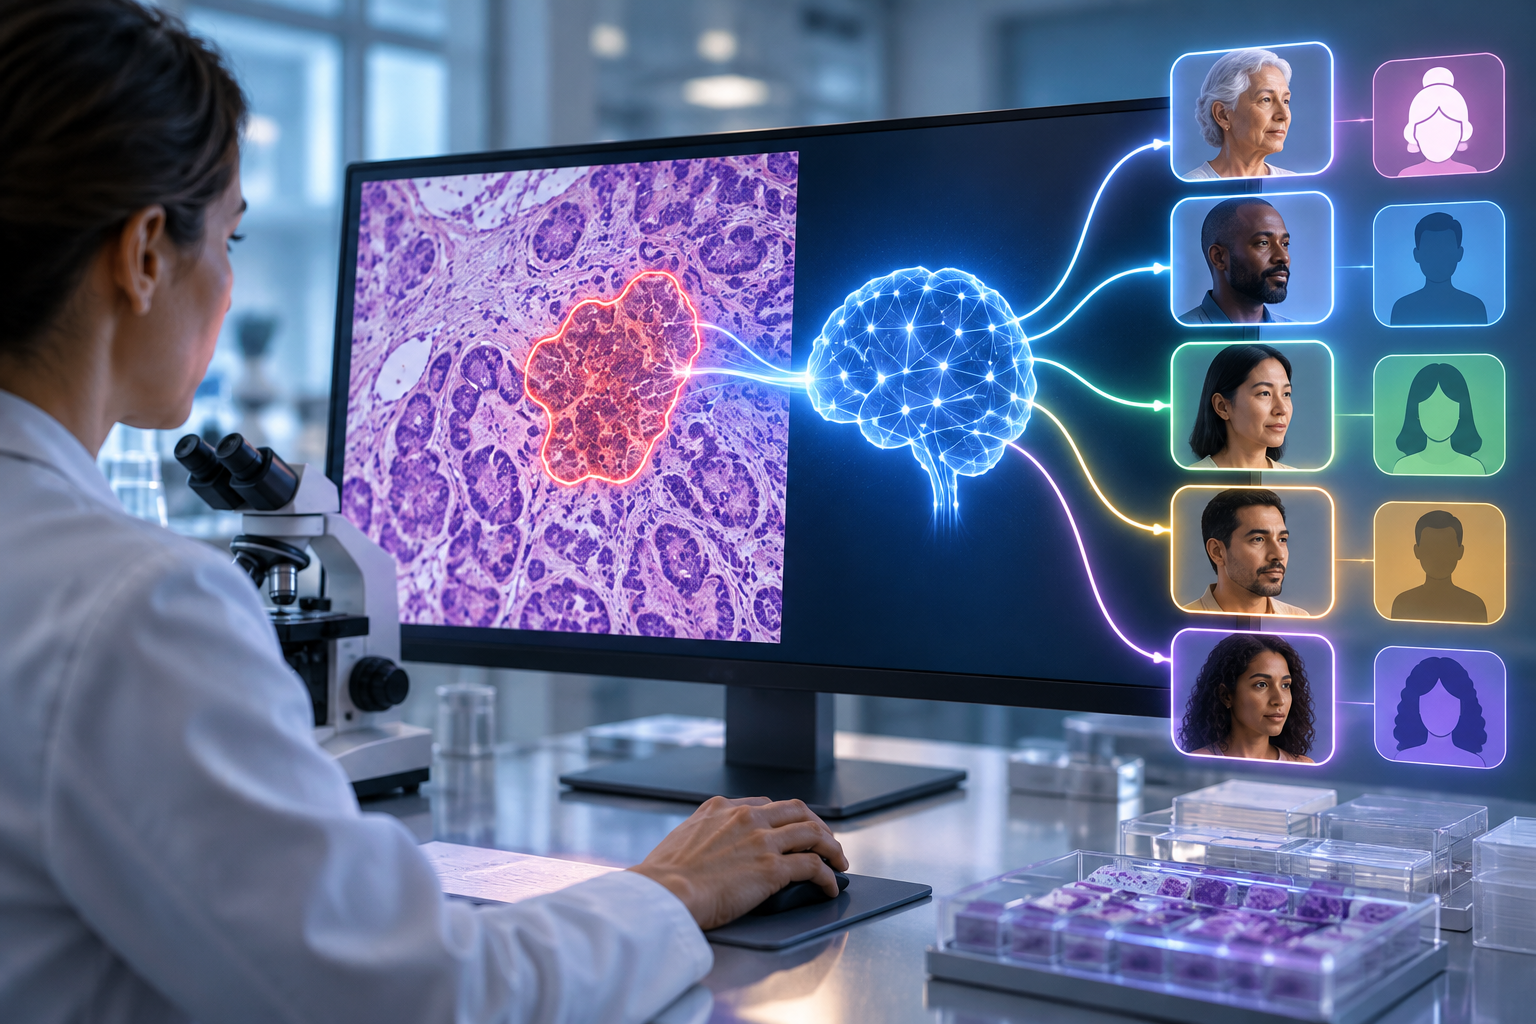
Модели искусственного интеллекта, применяемые в патологической диагностике рака по микроскопическим слайдам, способны не только выявлять признаки злокачественных новообразований, но и извлекать демографическую информацию о пациенте. Это может приводить к систематическим различиям в диагностической точности между группами пациентов.
Почему это важно
Классическая патология предполагает, что срез ткани содержит сведения о заболевании, но не даёт подсказок о личности пациента. Новые результаты показывают, что для ИИ это не всегда так: цифровые модели могут «читать» паттерны, связанные с расой, полом и возрастом, и использовать их при принятии диагностического решения. Вследствие этого точность классификации типов и подтипов рака может варьировать по демографическим группам.
Как проводили исследование
Исследователи проанализировали несколько широко применяемых моделей глубокого обучения для патологии, протестировав их на крупной многоинституциональной подборке слайдов, охватывающей около 20 типов рака. В четырёх моделях выявили повторяющиеся разрывы в производительности: в ряде диагностических задач точность была ниже для определённых групп, выделенных по расе, полу или возрасту. Проблемы проявлялись, в том числе, при дифференциации подтипов рака лёгкого, при классификации подтипов рака молочной железы у молодых пациентов и при выявлении некоторых опухолей молочной железы, почек, щитовидной железы и желудка в отдельных группах. В общей совокупности такие различия наблюдались примерно в 29% проанализированных задач.
Причины предвзятости
Авторы выделили три основных источника, объясняющих выявленные различия:
- Неравномерность обучающих данных. Некоторые демографические группы представлены в наборах данных хуже других, что затрудняет адекватное обобщение моделей на недопредставленные популяции.
- Различия в частоте заболеваний. В случаях, когда определённые виды или подтипы рака чаще встречаются в конкретных популяциях, модели сильнее «подстраиваются» под эти группы и хуже работают в популяциях с иной распространённостью заболеваний.
- Скрытые молекулярные отличия. Модели улавливают тонкие молекулярные и биологические сигналы, например ассоциированные с драйверными мутациями, и могут использовать их как прокси для диагностики, что снижает точность в группах, где такие мутации менее распространены.
В совокупности это означает, что предвзятость ИИ в патологии определяется не только балансом датасета, но и тем, какие признаки модель считает релевантными при обучении.
Методика снижения предвзятости — FAIR-Path
Для уменьшения диагностических диспропорций авторы предложили фреймворк FAIR-Path, основанный на контрастном обучении. Идея в том, чтобы изменить процесс обучения так, чтобы модель сильнее фокусировалась на признаках, характеризующих типы опухолей, и меньше обращала внимание на менее релевантные демографические различия. Применение этого подхода к тестируемым моделям позволило значительно сократить диагностические различия — в исследовании отмечено существенное снижение диспропорций.
Значение и дальнейшие шаги
Результаты подчёркивают необходимость регулярной оценки медицинских ИИ-систем на предмет предвзятости и разработки методов, повышающих справедливость моделей. В дальнейшем авторы планируют изучать поведение таких систем в разных регионах с отличающейся демографией, клинической практикой и лабораторными условиями, а также адаптировать методы для сценариев с ограниченными данными. Конечная цель — создать инструменты, которые помогают клиницистам ставить быстрые, точные и справедливые диагнозы для широкого круга пациентов.
Авторы и финансирование
Работа выполнена коллективом исследователей из научных и клинических учреждений; проект получил поддержку нескольких фондов и грантов, а также стипендии и награды. Среди авторов указаны ученые, клиницисты и специалисты по вычислительной биологии и патологии. Отмечены отдельные профессиональные связи и участия, о которых сообщают сами авторы.
Примечание о прозрачности
Авторы указывают, что при подготовке рукописи использовали инструменты для редактирования текста. При этом конечное содержание было пересмотрено и одобрено авторами.